La llegada de modelos LLM ternarios y su fine-tuning con Axolotl prometen llevar la inteligencia artificial avanzada a cualquier dispositivo, democratizando su uso.
La llegada de modelos LLM ternarios y su fine-tuning con Axolotl prometen llevar la inteligencia artificial avanzada a cualquier dispositivo, democratizando su uso.
Las nuevas herramientas de clonación y gestión vocal de Grok cambian la manera de crear, personalizar y proteger las voces humanas dentro de la inteligencia artificial.
Una nueva alianza liderada por Anthropic promete llevar la inteligencia artificial personalizada a empresas medianas mediante acompañamiento técnico y capital estratégico.
Descubre los desafíos de ingeniería y las decisiones clave que permiten que la voz IA de OpenAI sea realmente instantánea y natural, desde WebRTC hasta escalabilidad en la nube.
Kimi K2.6 es el modelo open source que trabaja durante 13 horas seguidas optimizando código real y desafía directamente a los modelos propietarios líderes.
Descubre cómo los modelos LLM ternarios están revolucionando la eficiencia y accesibilidad de la IA, y los retos aún abiertos en su integración con herramientas open source.
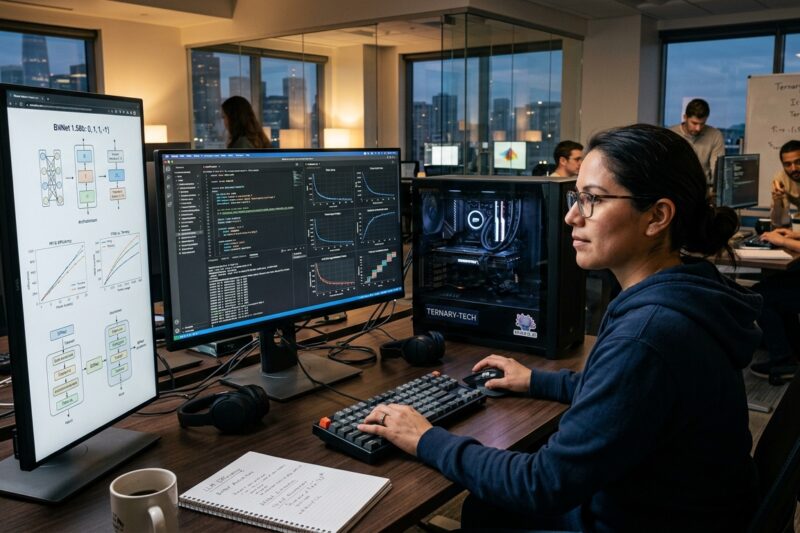
Los modelos LLM ternarios como BitNet, potenciados por Axolotl, revolucionan la IA eficiente permitiendo entrenamiento y ejecución en hardware de bajo costo.
Los modelos de lenguaje ternarios y el ecosistema Axolotl están dando forma a una era de LLMs ultra-eficientes, accesibles e innovadores para dispositivos de todo tipo.
Qwen Research revoluciona la IA de código abierto con FlashQLA para acelerar el procesamiento y Qwen-Scope para desentrañar el razonamiento de sus modelos.
Analizamos cómo FlashQLA optimiza el rendimiento de los modelos Qwen mediante kernels de atención lineal fusionados y paralelismo de contexto avanzado.